
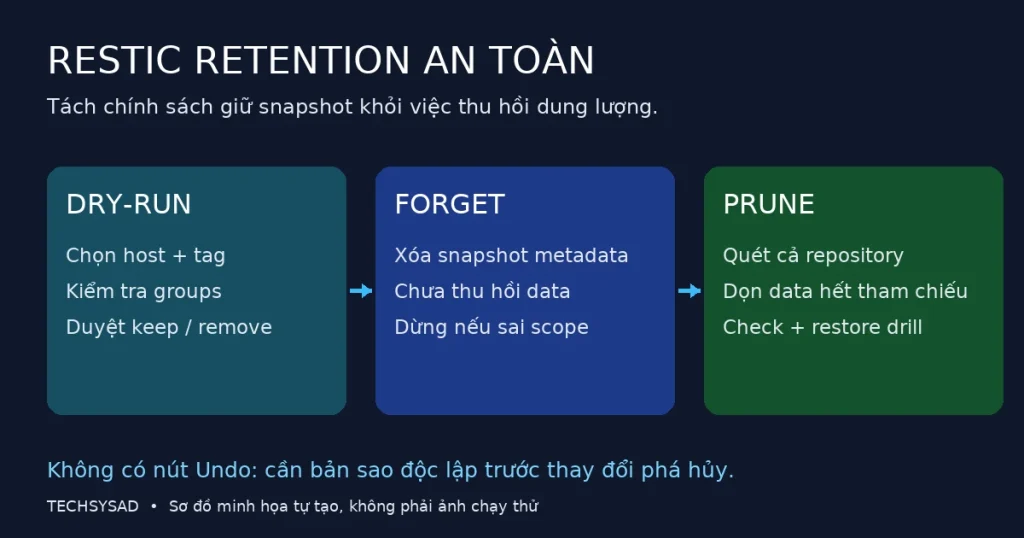
Restic retention không phải một lệnh “dọn backup cũ”. forget xóa snapshot khỏi danh sách khôi phục; prune mới thu hồi dữ liệu không còn được snapshot nào tham chiếu. Cách vận hành an toàn là xác định đúng phạm vi, duyệt --dry-run, bảo đảm còn điểm khôi phục tốt, rồi thực hiện hai bước trong cửa sổ bảo trì riêng.
Bài này dành cho admin đã có repository Restic trên Linux, nhất là server chạy Docker có nhiều host hoặc nhiều ứng dụng dùng chung kho. Nếu bạn chưa có pipeline tạo bản sao nhất quán, bắt đầu từ backup Docker volumes bằng Restic. Retention không sửa được snapshot database tạo lúc dữ liệu đang ghi dở.
Phạm vi và mức kiểm chứng: ví dụ dùng Bash trên Linux, Restic CLI và repository thông thường có quyền bảo trì; không phải recipe cho Swarm hay một backend Object Lock cụ thể. Đối chiếu tài liệu stable của Restic ngày 14/10/2026 và kiểm tra cú pháp Bash; chưa chạy các lệnh Restic trên repository thực tế. Nội dung có hỗ trợ AI biên soạn, không phải báo cáo benchmark hoặc chứng nhận production. Với append-only, đọc phần giới hạn bảo mật trước khi áp dụng policy.
1. Hiểu ranh giới: snapshot bị quên chưa đồng nghĩa data bị xóa
Snapshot lưu thông tin để tìm lại cây thư mục và nội dung. Các snapshot có thể dùng chung data blob nhờ deduplication. Sau forget, dữ liệu riêng của snapshot bị loại vẫn có thể còn trong kho, nhưng snapshot đó không còn là một điểm restore bình thường. Sau prune, dữ liệu không còn được tham chiếu có thể bị xóa hoặc các pack được đóng gói lại. Tài liệu Removing backup snapshots mô tả hai bước này rõ ràng.
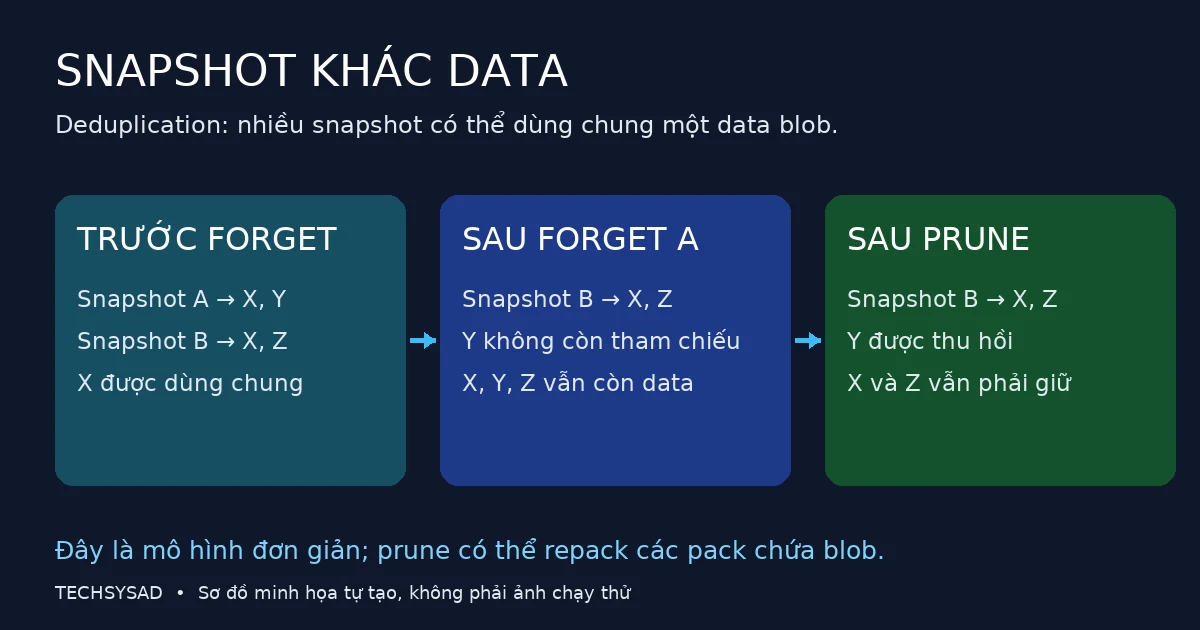
Trong sơ đồ: A dùng X,Y; B dùng X,Z. Quên A không làm mất X vì B vẫn cần X. Y chỉ có thể được thu hồi ở prune. Vì vậy tổng kích thước logic của snapshot bị quên không bằng dung lượng vật lý sẽ giải phóng; dữ liệu dùng chung và pack còn sử dụng giải thích nhiều trường hợp “prune xong kho vẫn lớn”.
- Muốn bỏ điểm restore theo policy: dùng forget với filter và dry-run trước.
- Muốn thu hồi phần data không được tham chiếu: dùng prune sau khi đã duyệt các snapshot còn lại.
- Muốn chứng minh dữ liệu đọc được: dùng check có đọc data và restore drill; không suy từ exit code của forget.
- Muốn bảo vệ trước ransomware: cần phân quyền/backend và bản sao độc lập; retention hoặc mã hóa không tự tạo tính bất biến.
2. keep-daily không phải “giữ mọi backup trong 7 ngày”
--keep-daily 7 giữ snapshot mới nhất của mỗi ngày trong bảy ngày có snapshot. Ngày không có backup không bị tính như một ngày có backup. Nếu lịch chạy bị gián đoạn, các snapshot được giữ có thể trải trên khoảng thời gian dài hơn một tuần. Weekly và monthly cũng chọn đại diện theo đơn vị lịch, không giữ mọi lần chạy.
--keep-within 7d giữ tất cả snapshot nằm trong khoảng bảy ngày tính từ snapshot mới nhất được xét, không phải cửa sổ tính từ thời điểm bạn chạy forget. Các tùy chọn --keep-within-daily vẫn chọn đại diện mỗi ngày trong khoảng tương ứng. Những điều kiện keep được kết hợp kiểu OR: thỏa một điều kiện là được giữ; 7 daily + 4 weekly + 6 monthly không có nghĩa chắc chắn đúng 17 snapshot vì chúng có thể trùng nhau. Nguồn: semantics policy của Restic.
Ví dụ giả định có backup thứ Hai, thứ Ba, thứ Sáu và thứ Bảy: keep-daily 3 giữ đại diện thứ Ba, thứ Sáu, thứ Bảy. Đây là minh họa logic, không phải output chạy thử. Đồng thời kiểm tra timestamp: policy tốt cũng không chứng minh backup mới nhất còn đáp ứng RPO nếu job đã ngừng chạy nhiều ngày.
3. Kiểm tra host, tags và paths trước khi chọn policy
Mặc định forget chia snapshot thành nhóm theo host,paths, rồi áp policy riêng cho từng nhóm. Filter chọn snapshot nào được xét; group-by quyết định các snapshot đó cạnh tranh với nhau theo nhóm nào. Đây là hai việc khác nhau. Đừng bỏ grouping chỉ vì muốn kho giảm nhanh.
restic version
restic forget --help
restic prune --help
restic snapshots --group-by host,paths
restic snapshots --json > snapshots-before.json
Chạy các lệnh trên trong shell đã cấu hình repository và credential hợp lệ. File JSON có thể chứa hostname, đường dẫn và tags nhạy cảm: lưu trong thư mục riêng với quyền hạn chế, không paste nguyên lên ticket public. Kiểm tra CLI địa phương hỗ trợ flags dùng trong bài trước khi tiếp tục.
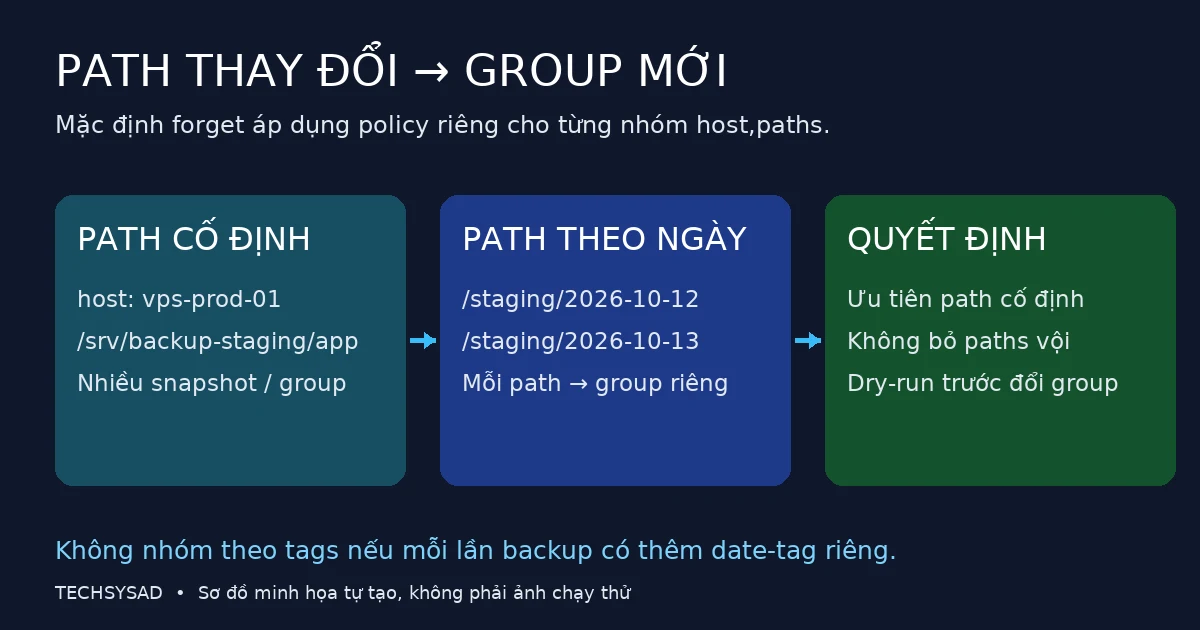
Một lỗi khó thấy: mỗi ngày backup đường dẫn staging mới, chẳng hạn /staging/2026-10-12 rồi /staging/2026-10-13. Với default host,paths, mỗi path khác trở thành nhóm khác; nếu mỗi nhóm chỉ có một snapshot, keep-last hoặc daily có thể giữ lại từng snapshot thay vì giảm lịch sử như bạn tưởng. Ưu tiên một root staging cố định, thay nội dung bên trong sau khi tạo dump nhất quán. Đường dẫn lịch sử vẫn thuộc nhóm cũ: xem xét riêng, không đổi group-by để gộp mù quáng. Nguồn: lựa chọn parent và grouping khi backup.
Nếu nhóm theo tags trong khi mỗi lần backup gắn thêm date-tag khác nhau, bạn lại chia nhỏ nhóm. Nếu loại paths khỏi group, hai bộ dữ liệu khác nhau của cùng host có thể cạnh tranh và bộ ít chạy có thể mất các điểm restore cần giữ. Chỉ đổi grouping khi đã liệt kê tất cả bộ dữ liệu bị gộp và xác nhận policy giữ đủ từng bộ.
--tag docker,app-web: chỉ xét snapshot có cả docker và app-web.--tag docker --tag app-web: xét snapshot có docker hoặc app-web; phạm vi rộng hơn.--host vps-prod-01kết hợp tag thu hẹp thêm phạm vi theo host; không thay thế kiểm tra paths.- Không dùng
--group-by "", keep-last 1 toàn kho hoặc tùy chọn cho phép xóa tất cả như một mẹo giải phóng disk.
4. Dry-run có phạm vi: cùng một bộ tham số cho preview và apply
Điều kiện dừng trước thao tác phá hủy: repository đang báo lỗi, không biết snapshot nào tốt, backup mới nhất quá RPO, filter không khớp ứng dụng mong muốn, hoặc chưa có bản sao độc lập đủ để phục hồi. File snapshots-before.json chỉ là danh mục: không chứa toàn bộ cây metadata và data, không phải backup của repository.
Mẫu sau dùng local repository để làm rõ phạm vi. Nếu dùng S3/SFTP/rclone, thay repository bằng URI thực tế và cấu hình credential backend riêng. Repository password không thay thế quyền đọc/ghi/xóa trên backend. Các đường dẫn và host/tag dưới đây là placeholder phải thay; không chạy với giá trị mẫu trên server thật.
#!/usr/bin/env bash
set -euo pipefail
umask 077

# Thay bằng kho và password-file hiện có, không tạo kho mới ở đây.
export RESTIC_REPOSITORY='/mnt/backup/restic-repo'
export RESTIC_PASSWORD_FILE='/etc/restic/repository-password'
HOST='vps-prod-01'
APP_TAG='app-web'

[[ -r "$RESTIC_PASSWORD_FILE" ]] || { echo 'Password file unreadable' >&2; exit 1; }
AUDIT_DIR="$(mktemp -d ./restic-retention-audit.XXXXXX)"
scope=(--host "$HOST" --tag "docker,$APP_TAG")
policy=(--group-by host,paths --keep-last 3 --keep-daily 7 --keep-weekly 4 --keep-monthly 6)

restic snapshots "${scope[@]}" --json > "$AUDIT_DIR/snapshots-before.json"
restic snapshots "${scope[@]}" --group-by host,paths
restic check
restic forget "${scope[@]}" "${policy[@]}" --dry-run 2>&1 | tee "$AUDIT_DIR/forget-dry-run.txt"
printf 'Review evidence in: %s\n' "$AUDIT_DIR"
Dry-run không xóa snapshot. Mẫu dùng pipefail để tee không che lỗi Restic; nếu check thất bại thì dừng trước khi lập kế hoạch. Check mặc định kiểm tra cấu trúc repository, không đọc và xác minh toàn bộ nội dung pack. JSON rỗng hoặc không có nhóm dự kiến là lý do dừng để kiểm tra filter, không phải bằng chứng “không cần backup”.
Policy 3 gần nhất, 7 daily, 4 weekly, 6 monthly chỉ là ví dụ biên tập, không phải chuẩn bắt buộc. Chọn theo số lần chạy/ngày, RPO, thời gian phát hiện xóa nhầm, dung lượng và yêu cầu lưu trữ. Đọc danh sách keep/remove, đối chiếu ID đã restore thành công và bảo đảm mốc tháng quan trọng không nằm trong remove. Giữ log theo cơ chế riêng tư phù hợp.
5. Apply forget rồi prune trong cửa sổ bảo trì
Trước khi apply: bảo đảm bản sao độc lập đã kiểm tra, tạm dừng các job backup/maintenance tới cùng repository trên mọi host theo quy trình hiện có; ghi lại cách và người chịu trách nhiệm bật lại. Không chỉ tránh chạy trùng trên một máy. Khi không còn job khác, chạy lại dry-run bằng đúng scope/policy trên vì kế hoạch cũ có thể đã thay đổi.
# Cùng shell có scope[] và policy[] của mẫu trên.
# Chỉ chạy sau khi DUYỆT danh sách remove và có phương án phục hồi.
restic forget "${scope[@]}" "${policy[@]}"
restic snapshots "${scope[@]}" --group-by host,paths

# Prune áp dụng cho TOÀN repository, không chỉ host/tag vừa forget.
restic prune --dry-run
# Đọc kế hoạch thu hồi/repack, kiểm tra dung lượng và cửa sổ bảo trì.
restic prune
restic check
Lệnh prune không kế thừa filter host/tag của forget: nó thu hồi tất cả data hiện không còn được tham chiếu trong repository, kể cả data từ các lần forget trước đó của ứng dụng khác. Nếu không được phép bảo trì toàn kho, dừng tại đây và phối hợp với chủ kho; không cố thêm filter giả cho prune.
Prune có thể lock repository, khiến backup không hoàn tất trong thời gian bảo trì, và có thể phải download/re-upload pack để repack. Cần kiểm tra chỗ trống, băng thông, chi phí request/egress với backend thật; không có tỷ lệ “dự phòng 10%” phổ quát. Nguồn: quy trình prune và các tùy chọn kiểm soát repack. Với kho lớn, tách maintenance khỏi backup giúp đọc log và kiểm soát cửa sổ rõ hơn, thay vì gắn forget –prune vào mọi lần chạy.
6. Tiêu chí thành công: không chỉ nhìn dung lượng giảm
# Đọc toàn bộ data khi chi phí/cửa sổ bảo trì cho phép.
restic check --read-data

# Hoặc kiểm tra một phần có chủ đích; đây KHÔNG phải full check.
restic check --read-data-subset=1/5

# Chọn FULL_SNAPSHOT_ID từ danh sách còn giữ, không dùng latest toàn kho.
FULL_SNAPSHOT_ID='THAY_BANG_ID_THUC_TE'
RESTORE_DIR="$(mktemp -d ./restic-restore-drill.XXXXXX)"
restic ls "$FULL_SNAPSHOT_ID"
restic restore "$FULL_SNAPSHOT_ID" --target "$RESTORE_DIR" --include '/srv/backup-staging/app'
Thay include bằng đường dẫn thực tế trong restic ls. Target là thư mục mới, không phải Docker volume đang phục vụ. Không thêm –delete và không restore đè vào production để thử. Với snapshot có đường dẫn tuyệt đối, thư mục restore vẫn chứa cấu trúc đường dẫn bên dưới target. Nguồn: restore và include/overwrite.
- Các lệnh kết thúc không lỗi; check không báo corruption; bộ snapshot còn lại đúng host, tags, paths và mốc cần giữ.
- Full check đọc toàn bộ pack; subset chỉ đọc một phần. Chạy subset 1/5 đến 5/5 có thể kiểm tra các phần của kho, nhưng kho thay đổi giữa các lần chạy không tương đương một ảnh chụp kiểm chứng toàn bộ tại một thời điểm. Random 5% lặp nhiều lần không bảo đảm đã đọc hết.
- Restore một mẫu file quan trọng; so checksum với manifest tin cậy có sẵn, kiểm tra permissions/ownership. Với database, import vào instance cách ly và chạy kiểm tra logic nghiệp vụ; checksum của dump không chứng minh database dùng được.
- Ghi thời gian restore thực tế để đối chiếu RTO; không gán số phút “chuẩn”. Bật lại job đã tạm dừng, quan sát lần backup tiếp theo và kiểm tra freshness đáp ứng RPO.
Nếu cần thiết kế bước kiểm chứng dữ liệu Docker riêng, xem snapshot, checksum và restore drill cho Docker volume. Hai bài bổ sung nhau: bài đó chứng minh khả năng phục hồi workload; bài này bảo vệ phạm vi và lịch sử khi dọn repository. Nguồn chính thức về check và read-data.
7. Troubleshooting và rollback thật sự
- Forget không xóa gì: kiểm tra danh sách filtered snapshots và nhóm host,paths. Path/date-tag thay đổi có thể tạo nhiều nhóm nhỏ; hoặc mọi snapshot đều khớp một điều kiện keep. Không “sửa” bằng cách xóa tất cả rồi backup lại.
- Prune không giảm nhiều dung lượng: dedup/shared blobs hoặc pack được giữ còn chứa data hữu ích. Xem thống kê prune, usage thật của backend và cơ chế versioning/lifecycle; dung lượng object version cũ có thể vẫn bị tính riêng. Không xóa pack thủ công.
- Repository locked: tìm process/job còn chạy trên tất cả host và kiểm tra kết nối. Chỉ xử lý stale lock theo tài liệu sau khi xác nhận không còn operation đang hoạt động; không unlock chỉ để ép hai maintenance chạy đồng thời.
- AccessDenied hoặc Object Lock chặn xóa: credential backup có thể không có quyền delete, hoặc backend giữ object theo chính sách. Dừng và làm việc với người quản trị storage; không tắt retention bảo vệ hay cấp quyền xóa cho mọi client để vượt lỗi.
- Check báo lỗi: ngừng forget/prune, giữ log và bản sao hiện trạng nếu có thể; dùng hướng dẫn repair đúng lỗi sau khi đã có kế hoạch phục hồi. Không chạy sửa chữa mù quáng để “xanh dashboard”.
Rollback cấu hình và rollback dữ liệu khác nhau. Nếu dry-run chọn sai, chưa thay đổi snapshot: sửa filter/policy rồi preview lại. Nếu đã forget, hoàn tác script không đưa snapshot trở lại; không coi data còn chưa prune là cơ chế Undo được bảo đảm. Nếu đã prune, phần data không còn tham chiếu có thể đã bị xóa. Phương án tin cậy là repository/bản sao độc lập đã xác minh hoặc khả năng phục hồi version của backend đã được diễn tập.
Để chuẩn bị trước thay đổi lớn, restic copy có thể chuyển các snapshot cần giữ sang repository thứ hai đã được tạo và cấu hình đúng. Copy cần đọc/ghi data, có chi phí và vấn đề chunker/dedup giữa kho: không đồng nhất với “copy xong tức thì”. Giữ kho thứ hai ngoài quyền xóa của job bảo trì kho chính, check và restore thử từ kho thứ hai. Khi phục hồi, dùng bản sao để tạo một kho thay thế/điểm restore được kiểm chứng; không đồng bộ xóa nhầm ngược sang bản sao.
8. Append-only: policy calendar có một bẫy bảo mật
Không dùng mẫu keep-daily/weekly ở trên như phương án chống client bị chiếm quyền. Theo cảnh báo append-only của Restic, client vẫn có thể thêm snapshot rác có timestamp mới hơn trong cùng khoảng lịch, khiến maintenance chọn snapshot rác thay snapshot tốt. Tài liệu khuyến nghị keep-within trong bối cảnh này và maintenance từ máy tách biệt có quyền đầy đủ. Nhưng keep-within vẫn là cửa sổ hữu hạn; cần phát hiện compromise trước khi snapshot tốt vượt cửa sổ và xác nhận snapshot mới nhất đáng tin.
Repository password/key mở khả năng giải mã; quản lý key của Restic không tự tạo vai trò IAM chỉ-ghi hoặc ngăn người có quyền backend xóa kho. Thiết kế quyền backend, máy maintenance và bản sao độc lập là lớp bảo vệ khác. Đừng gọi “mã hóa + retention” là immutable backup nếu chưa xác minh backend thực thi bất biến.
Checklist duyệt maintenance
- Đã liệt kê toàn kho và phạm vi ứng dụng; hostname, tags, paths không bị chọn nhầm.
- Đã hiểu calendar vs within, các điều kiện keep OR và grouping; có snapshot tốt đáp ứng yêu cầu phục hồi.
- Có bản sao độc lập đã check/restore; danh mục JSON không được coi là backup.
- Dry-run vừa chạy lại; danh sách remove đã duyệt sau khi dừng các job liên quan.
- Đủ quyền bảo trì toàn kho và tài nguyên cho prune; không vượt policy Object Lock.
- Check và restore drill đạt tiêu chí có ghi bằng chứng; job được bật lại và backup tiếp theo được theo dõi.
Bước tiếp theo nên là kiểm tra grouping của repository hiện tại và chạy preview, không phải copy nguyên lệnh xóa. Khi chưa xác định được một snapshot tốt và một đường phục hồi độc lập, việc dọn kho có thể chờ; mất lịch sử phục hồi thì không thể giải quyết bằng một lần backup mới.
Nguồn đối chiếu
- Restic — Removing backup snapshots: policy, grouping, prune và append-only.
- Restic — Working with repositories: snapshots, copy, integrity checks.
- Restic — Restoring from backup: include, target và overwrite.
- Restic — Backing up: parent selection và group-by.
- Restic — Encryption: repository keys/passwords.
Tài liệu được đọc ngày 14/10/2026. Các sơ đồ là minh họa tự tạo bằng code, không phải screenshot hay bằng chứng chạy thử. Kiểm tra lại –help của bản Restic bạn đang vận hành trước khi áp dụng.